結論から言う。Claude CodeのAPIエラー、つまり API Error で始まる行は、サーバー側・上限・リクエスト側・ネットワークの4つに割れる。この4つは対処がまったく違う。待てば直るものに設定を足しても意味はなく、自分で直すものを待っても永遠に直らない。
やりにくいのは、画面に出るのが1行だけで、しかもその1行が出るまでにClaude Codeが既に何度も再送を終えている点だ。529 を見て「混んでいるのか」と数分待つのは正しいが、Request rejected (429) を同じように待っても直らない。前者はサービス全体の容量、後者は自分のキーやプロジェクトに設定されたレート上限の話だからだ。同じ「429」でも意味が3つある。
以下は、メッセージの4分割から、自動リトライの読み方、5xxと529と429の見分け、3種類のタイムアウト、応答が途中で切れたときの扱い、コンテキスト超過とリクエストサイズ超過の区別、無人実行での失敗の出し方までを、実際に触る順に並べたものだ。文言・既定値・バージョン番号は公式ドキュメントの記載に合わせている。
この記事の要点
API Errorの行はまず4つに割る:サーバー側(500/529)、上限(session limit /Request rejected (429)/ spend limit)、リクエスト側(Prompt is too long/Request too large)、ネットワーク(Unable to connect to APIなど)。- エラーが画面に出た時点で、自動リトライは終わっている:Claude Codeは一時的な失敗を既定で10回、指数バックオフで再送する。だから「もう一度すぐ実行」は多くの場合いちばん効果が薄い。
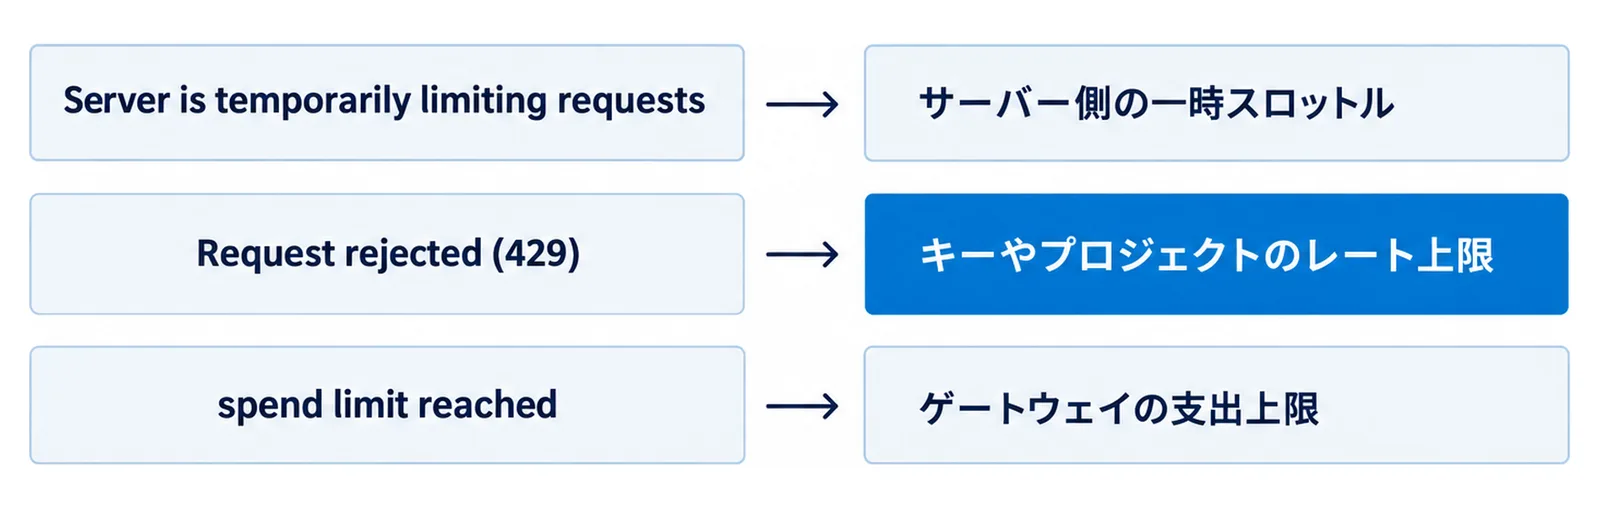
529はクォータを消費しない:容量はモデル単位で管理されるので、/modelで別のモデルに切り替えれば作業は続けられる。- 429は3種類ある:サーバー側の一時スロットル、キーやプロジェクトのレート上限、ゲートウェイの支出上限。どれかは文言で決まる。
Prompt is too longとRequest too largeは別物:前者はコンテキスト窓、後者はリクエストボディの32MB上限。/compactが効くのは前者と、画像が原因の後者だけ。- 無人実行では失敗の出方を先に決める:
CLAUDE_CODE_MAX_RETRIESを下げて早く落とすか、CLAUDE_CODE_RETRY_WATCHDOG=1で容量エラーを待ち続けるか、CIの性格で選ぶ。
手順1|API Error の1行を4つに割る
最初にやることは、エラー文の分類だ。Claude Codeのエラーメッセージは種類ごとに文言が決まっているので、1行読めばどのレイヤーの問題かはほぼ確定する。Anthropic「Error reference」の章立てもこの分け方に沿っている。
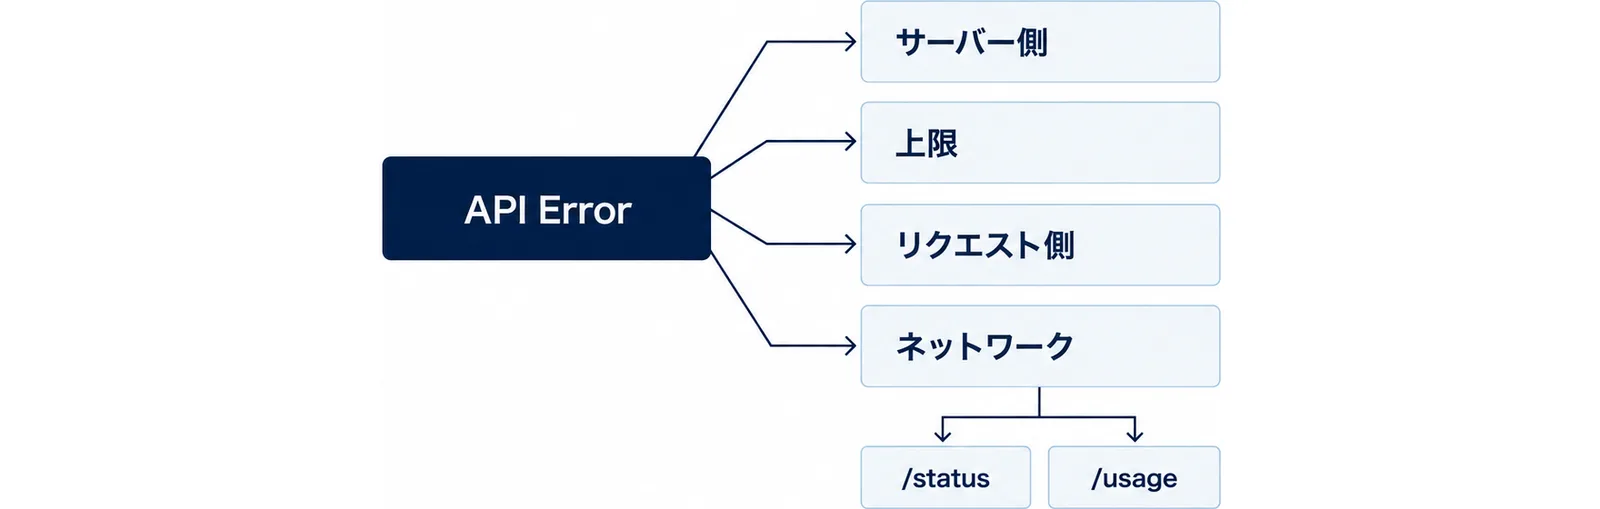
4つの分類と、そこに入る代表的な文言
サーバー側。推論プロバイダの中で起きた失敗だ。API Error: 500 Internal server error のように、Claude Codeは5xx応答のステータスコードとAPIのエラーメッセージをそのまま出す。API Error: Repeated 529 Overloaded errors も同じ層にある。プロンプト・設定・アカウントが原因ではない。
上限。アカウントやプランに紐づくクォータに達した状態だ。サブスクリプションなら You've hit your session limit · resets 3:45pm のように、リセット時刻つきで出る。APIキーやクラウドプロジェクトのレート上限なら API Error: Request rejected (429)、支出の上限なら You've hit your monthly spend limit · raise it at claude.ai/settings/usage だ。
リクエスト側。送ろうとした内容そのものが通らない状態で、Prompt is too long(対話セッションでは Context limit reached · /compact or /clear to continue)や Request too large (max 32MB) が入る。ここはリトライではなく、送る量を減らすしかない。
ネットワーク。リクエストが宛先に届かない、または戻りの応答が途中で書き換えられた状態だ。Unable to connect to API. Check your internet connection や Can't reach the API server — check your internet or DNS (ENOTFOUND)、Socket is closed がこの層にあたる。
分類のあとに開く3つの画面
分類できたら、次はそれを裏づける情報を見る。使う画面は3つで足りる(それぞれの機能はAnthropic「Commands」に載っている)。
/status— バージョン、モデル、アカウント、そしていまアクティブな資格情報が出る。上限系のエラーでは最初にここを見る。環境に残ったANTHROPIC_API_KEYがサブスクリプションを上書きしていると、意図しない低いティアのキーでリクエストが飛ぶ。/usage— セッションのコストと、プランの上限、それぞれのリセット時刻が出る。「あと何分待てばいいのか」はここで分かる。/doctor— インストール、設定、拡張、コンテキスト使用量をまとめて点検し、適用できる修正は確認のうえで提案してくれる。claudeがそもそも起動しないなら、シェルからclaude doctorを実行する(この振り分けはAnthropic「Troubleshooting」に記載がある)。
ここで「ネットワーク」に落ちた場合、この記事の残りはほとんど効かない。社内プロキシやTLS傍受の設定が原因のことが多いので、Claude Codeのプロキシ設定7手順|繋がらない時のほうに進んでほしい。
手順2|自動リトライがどこまで終わっているかを先に読む
ここを飛ばすと、以降の判断が全部ずれる。Claude Codeは一時的な失敗を、指数バックオフで最大10回まで再送してからエラーを表示する。つまり画面にエラーが出た時点で、その失敗に対する再送はすでに使い切られている(回数と条件はAnthropic「Error reference」の記載)。
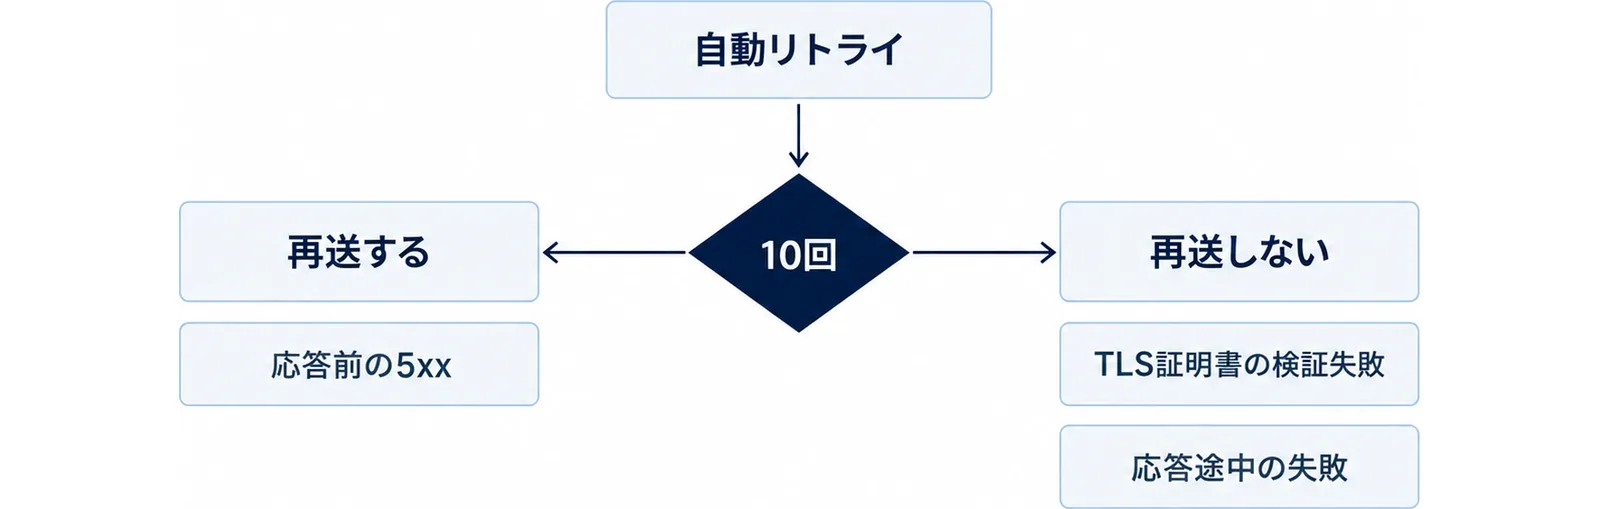
再送する失敗と、しない失敗
再送されるのは、主に「Claudeの応答が1文字も流れてくる前に起きた失敗」だ。応答前の5xx、過負荷応答、リクエストタイムアウトが入る。接続が途中で落ちた場合も、Claudeが応答を完了していなければ同じバックオフで再送され、ターンは続く。コンピュータがスリープに入って切れたケースもこの扱いで、理由が特定できると再送のラベルは Connection lost while your computer was asleep になる。
一時的な 429 スロットルも再送される。claude.aiのサブスクリプションでサインインしている場合は、プランのクォータヘッダを持たない429もここに含まれる(v2.1.199より前は、この種の429を再送するのはAPIキーとEnterpriseのサインインだけだった)。入力と max_tokens の合計がコンテキスト上限を超えて拒否された場合は、同じ内容を送れば同じ結果になるので、max_tokens を下げて再送する。縮められない場合は再送をやめて圧縮に回る。
再送されないものもはっきりしている。ひとつはTLS証明書の検証失敗だ。TLSを覗くプロキシ、NODE_EXTRA_CA_CERTS のバンドル不足、期限切れの証明書がここに当たる。証明書設定はすぐ直せる問題なので、Claude Codeは1回目で報告する。もうひとつは応答途中の失敗、つまりClaudeがテキストのブロックやツール呼び出しを1つ完了した後に起きた失敗だ。ここで再送すると同じツール呼び出しを二重に実行してしまうため、Claude Codeはリクエストを再実行しない。
待っている最中に画面に出るもの
再送中はスピナーに Retrying in Ns · attempt x/y のカウントダウンが出る。ラベルは最初は API error だが、v2.1.198以降は3回目の試行から具体的な理由に切り替わる。529の過負荷なら、カウントダウンの下にサービス状況の確認先も出る。
まだ失敗していない状態の表示もある。リクエストが処理中のまま20秒データが来ないと、Waiting for API response · will retry in … · check your network が出る。これは失敗ではなく、Claude Codeが停止した接続を打ち切るまでのカウントダウンだ。データが再開すれば自然に消える。毎回出るならネットワーク側の問題として扱う(v2.1.185より前は10秒で、文言も違っていた)。なおAnthropic「Error reference」によれば、アドバイザーの確認中だけは閾値が20秒ではなく90秒になる。長いレビューでは20秒以上なにも送られてこないことがあるからだ。
手順3|500 と 529 は待つ、429 は「誰の上限か」を見分ける
ここが本題だ。3つとも「サーバーが断った」系だが、対処が別々になる。
500 — 待つ。プロンプトの貼り直しは不要
API Error: 500 Internal server error. This is a server-side issue, usually temporary — try again in a moment. If it persists, check https://status.claude.com.
APIの内部で起きた想定外の失敗で、プロンプト・設定・アカウントが原因ではない。末尾の一文はプロバイダごとに変わり、Amazon Bedrock、Google CloudのAgent Platform、Microsoft Foundryならそのプロバイダのサービス状況、独自の ANTHROPIC_BASE_URL ならそのゲートウェイのホスト名が入る。
やることは3つ。status.claude.com(またはメッセージが名指ししたプロバイダのページ)で障害が出ていないか見る。1分待って送り直す。このとき長いプロンプトを貼り直す必要はない。元のメッセージは会話に残っているので、try again と打てばいい。障害情報が出ていないのに続くなら /feedback を送る。
529 — 待つか、モデルを変えて作業を続ける
API Error: Repeated 529 Overloaded errors. The API is at capacity — this is usually temporary. Try again in a moment. If it persists, check https://status.claude.com.
全ユーザー共通で容量が一時的に足りない状態だ。重要なのは、529は自分の使用量上限ではなく、クォータも消費しないという点だ。数分待つのが基本だが、容量はモデル単位で管理されているので、/model で別のモデルに切り替えれば作業は続けられる。特定のモデルに負荷が寄っているときは、Claude Code自身が Opus is experiencing high load, please use /model to switch to Sonnet のように切り替えを促してくる。
429 は3種類ある
同じ429でも、文言が違えば原因も対処も違う。サーバー側の一時スロットル、キーやプロジェクトのレート上限、ゲートウェイの支出上限の3つを、出ている文言で見分ける。
429その1|サーバー側の一時スロットル
API Error: Server is temporarily limiting requests (not your usage limit)
プランのクォータとは無関係の短命なスロットルだ。Claude Codeは、本物の上限応答が持つ統一クォータヘッダの有無でこれを見分けている。v2.1.199以降はサインイン方法にかかわらず自動で再送されるので、見えている時点で数回は試したあとだ。少し待って送り直し、続くならstatus.claude.comを見る。
429その2|キーやプロジェクトのレート上限
API Error: Request rejected (429) · this may be a temporary capacity issue. If it persists, check https://status.claude.com.
APIキー、Amazon Bedrockのプロジェクト、Google Cloudのプロジェクトに設定されたレート上限に当たった状態だ。ここで最初にやるのは /status でアクティブな資格情報が意図したものかを確認することで、環境に紛れ込んだ ANTHROPIC_API_KEY がサブスクリプションではなく低いティアのキーにリクエストを流している、というのが典型的な外し方だ。キーのティアと上限の考え方はAnthropic「Rate limits」に、Bedrock経由のクォータはAWS「Quotas for Amazon Bedrock」にまとまっている。並列実行が多くて踏んでいるなら、CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY を下げる、サブエージェントを同時に走らせすぎない、高頻度のスクリプトでは /model で小さいモデルに寄せる、のいずれかで密度を落とす。
429その3|ゲートウェイの支出上限
spend limit reached (daily; resets 2026-08-09 00:00 UTC)
小文字の spend limit reached は、自分のプランではなくゲートウェイ運用者が設定した支出上限だ。メッセージが期間とリセット時刻を名指しするので、そこまで待つか、運用者に引き上げを頼む。運用者が blocked_message を設定していれば、その指示が後ろに続く(v2.1.225より前は spend limit reached だけが出ていたので、古い版のゲートウェイでは短い形のまま届く)。ゲートウェイ側で開発者ごとに上限を切る設計は、Claude Code支出上限|gatewayで開発者別に設定で整理している。
サブスクリプションの上限はこの3つとは別系統
You've hit your session limit · resets 3:45pm や You've hit your weekly limit · resets Mon 12:00am は429ではなく、プランのローリング上限だ。セッションと週次の上限は全モデル共通なので、モデルを変えても回復しない。一方で You've hit your Opus limit や You've hit your Sonnet limit はそのモデルファミリーだけの上限なので、/model で別ファミリーに移れば作業は続く。/usage でプランの窓とリセット時刻を確認できる。この系統の運用はClaude Codeの「session limit」対処法|再開手順に切り出してある。
手順4|タイムアウトは「どこで待ち切れたか」で3つに分かれる
「しばらく待っていたら落ちた」という症状は、待っていた場所が3か所あるので分けて読む。
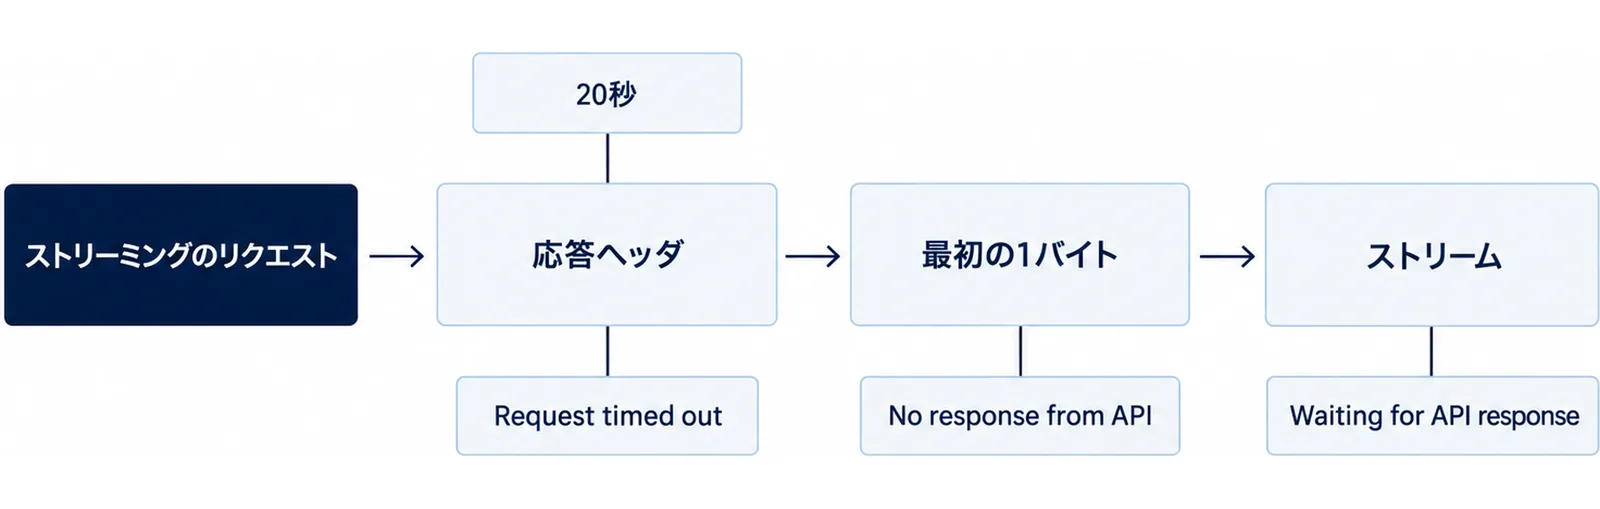
Request timed out — リクエスト全体の期限
Request timed out
APIが接続の期限までに応答を返さなかった状態だ。既定のリクエストタイムアウトは10分で、高負荷時や、モデルが非常に長い応答を生成しているときに起きる。やることは、送り直す、長い作業を小さなプロンプトに割る、遅いネットワークやプロキシが原因なら API_TIMEOUT_MS(既定 600000 ミリ秒)を上げる、の3つだ。頻発してネットワークに問題がないなら、ネットワーク側のエラーとして扱い直す。
No response from API — 応答ヘッダが来ない
API Error: No response from API (waited 3m, then 10m on the retry). If a proxy or gateway on your network holds responses until they complete, raise API_TIMEOUT_MS or CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS to wait longer.
ストリーミングのリクエストを送ったが、最初の1バイトの期限までに応答ヘッダが返ってこなかった状態だ。Claude Codeは API_TIMEOUT_MS の10分を待ちきらずに打ち切り、再送を最大1回だけ行う。
待ち時間は初回と再送で別に決まる。初回は CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS を1以上に設定していればその値で、10秒から30分の範囲に収められる(この変数はv2.1.242以降)。未設定なら、バイト単位の監視タイマーの値が使われる。再送は API_TIMEOUT_MS より1秒短い値、既定では10分弱だ。応答を生成し終えるまで溜め込むプロキシやゲートウェイがあっても、再送のほうが待ち切れるようにこうなっている。Amazon Bedrockでは再送も初回と同じ期限を使うため、メッセージに出る時間は1つになる。なお正の API_TIMEOUT_MS が11秒未満だと、この期限そのものが無効になる。
対処は症状で分かれる。1回送り直して通るなら一時的なものだ(ここでも try again で足りる)。毎回出るならプロキシ側の問題で、接続は受けるがリクエストを転送しないプロキシは毎回このエラーになる。応答を溜め込むタイプのプロキシなら API_TIMEOUT_MS を上げる。初回だけ落ちて再送では通るという出方なら、CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS を上げて初回の待ち時間も伸ばす。v2.1.242より前は API_TIMEOUT_MS の10分を待ち切ってから失敗していたので、古い版では症状の出方自体が違う。
20秒の無データは、まだ失敗ではない
3つめは手順2で触れた Waiting for API response · will retry in … · check your network だ。リクエストは失敗しておらず、停止した接続を打ち切るまでの猶予が走っている状態だ。ここで慌てて Esc を叩くより、カウントダウンを見てから判断したほうが早い。打ち切ったあとの挙動は、応答がどこまで進んでいたかで変わる。何も完了していなければ再送かエラー、テキストやツール呼び出しを1つ完了していれば次の手順5の扱いになる。
「遅い」が恒常的なもので、特定のエラーに落ちないなら、原因はAPIではなくセッション側にあることが多い。その場合はClaude Codeが遅い原因と対処7手順を見てほしい。
手順5|The response above may be incomplete は再送しないのが正しい
これは対処を間違えやすい。エラーに見えるが、Claude Codeが意図して再送を止めた状態だ。
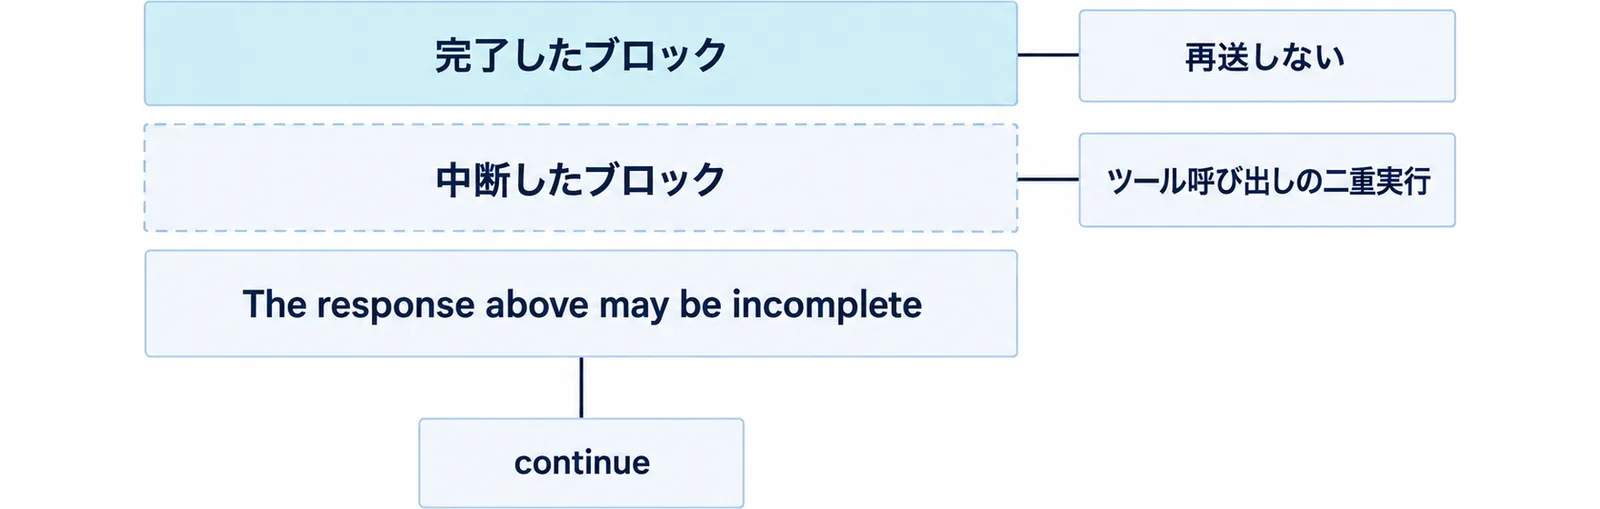
応答が流れている途中、Claudeがテキストのブロックかツール呼び出しを1つ完了した後に失敗したとき、再送すると同じツール呼び出しの二重実行になりうる。そこでClaude Codeは、Claudeが完了したブロックを保持したまま、この注記を付ける。
4つの文言で、切れた理由が分かる
文言は失敗の種類ごとに4つある。
API Error: Server error mid-response. The response above may be incomplete.
API Error: Connection lost mid-response. The response above may be incomplete.
API Error: Your computer went to sleep mid-response. The response above may be incomplete.
API Error: The response stopped arriving. The response above may be incomplete.
Server error mid-response— ストリーム途中の過負荷または5xx。この形はv2.1.199以降で、それ以前は部分出力を捨ててターン全体をエラーにしていた。Connection lost mid-response— 接続が落ちた。Your computer went to sleep mid-response— 応答の途中でコンピュータがスリープに入ったことを検出した。復帰後、Claude Codeは接続を切れたものとして扱い、読み取りをやめる。The response stopped arriving— 接続は開いたままデータが止まり、監視タイマーが打ち切った。
v2.1.227より前は、Connection lost mid-response が Connection closed mid-response、The response stopped arriving が Response stalled mid-stream という文言だったので、古い版のログを読むときは読み替える。
対話セッションでの続け方
画面に残っているものをまず読む。Claude Codeはエラー前にClaudeが完了したブロックはすべて残すが、ターンが終わるときに中断したブロックは捨てるので、最後の数文やツール呼び出しが欠けていることがある。そのうえで continue と返せば、Claudeは最後に完了したブロックから拾い直す。
非対話(-p)では出方が変わる。既定のテキスト出力では、ターンの途中で保持していた最後の完了ブロックに続けてこのメッセージが出る。保持しているものが無ければメッセージだけになる。--output-format json や stream-json では result フィールドに入る。サブエージェントの場合は、切れた応答にテキストがあってツール呼び出しが無ければ、Claude Code自身がサブエージェントに続きを促すので、この注記がサブエージェントの最後のメッセージになるのは、その継続を使い切ったときだけだ。
手順6|Prompt is too long と Request too large を混同しない
どちらも「大きすぎる」だが、超えている上限が別で、効く対処も別だ。
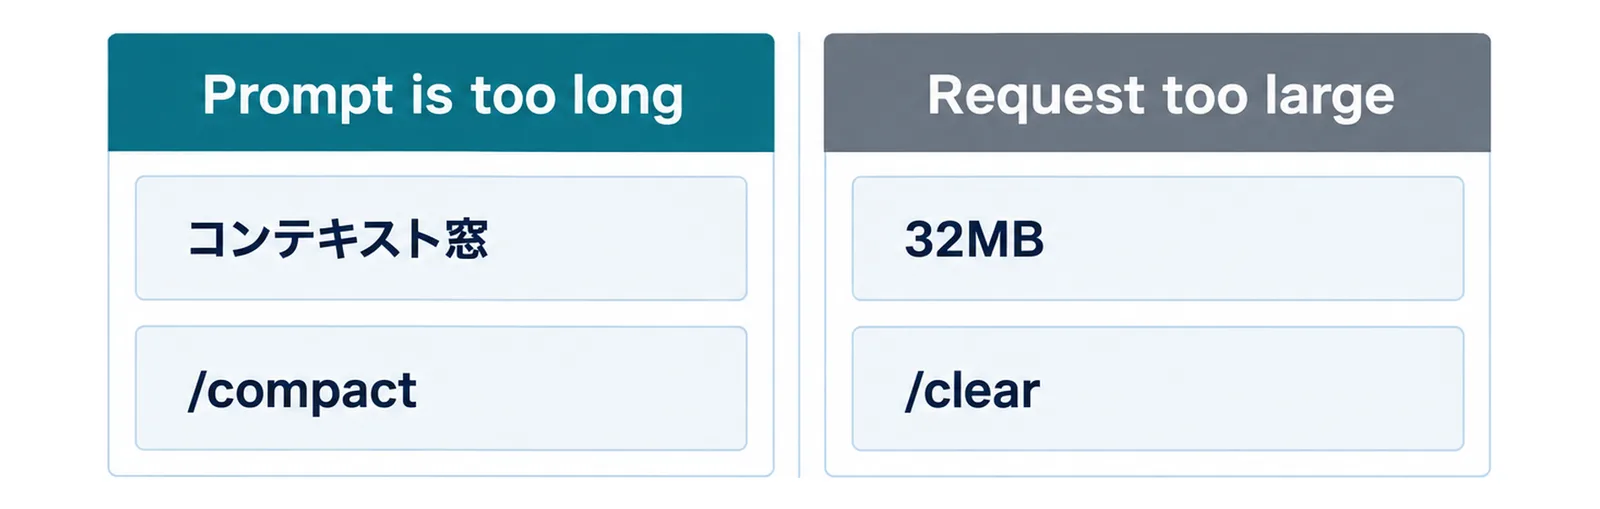
Prompt is too long — コンテキスト窓を超えた
会話と添付ファイルの合計がモデルのコンテキスト窓を超えた状態だ。対話セッションでは次の形で出る。
Context limit reached · /compact or /clear to continue
DISABLE_COMPACT を設定していると /clear だけが案内される。自動圧縮を利用者設定で切っている場合は · auto-compact is off · /config to turn it on が付く。-p の出力とトランスクリプトでは Prompt is too long のままだ。Amazon Bedrockはこの状態を Input is too long for requested model. と報告し、Claude Codeは同じものとして扱う(v2.1.217より前はBedrockの文言を認識せず、自動圧縮が走らなかった)。
自動圧縮が走って別の原因で失敗した場合は、Prompt is too long · automatic compaction failed: <the underlying error> のように原因が併記される。この場合は名指しされたエラーを先に解決する。解決するまで /compact も同じ理由で失敗する。
やることの優先順位はこうだ。
/compactで以前のやり取りを要約して空きを作る。/clearなら最初からやり直す。/compactがNot enough messages to compact.と返したら、会話が1往復しかないという意味で、その1つのプロンプトとClaude Codeが一緒に送るものが窓を埋めている。/contextで内訳を見る。システムプロンプト、ツール、メモリファイル、メッセージのどれが食っているかが分かる。- 使っていないMCPサーバーを
/mcp disable <name>で切る。ツール定義がコンテキストから外れる。 - 大きい
CLAUDE.mdを削る、またはパス限定のルールに移して必要なときだけ読ませる。 - サブエージェントは親セッションのMCPツール定義をすべて引き継ぐので、起動前に不要なサーバーを切る。
- 自動圧縮は既定で有効だ。
/configやDISABLE_AUTO_COMPACTで切っているなら戻す。切ったままにするなら、窓が埋まる前に自分で/compactを打つ。
1往復しかない会話と、圧縮そのものの失敗
会話が1往復しかない場合、要約する過去が無いのでClaude Codeは圧縮を試さず、代わりに何が容量を占めているかを説明する。APIがトークン数を返していれば、会話自身の中身が大半なのか、システムプロンプト・ツール定義・添付の側が大半なのかまで書き分ける。前者なら送る内容を減らし、後者なら添付とツール定義を減らす、と対処が分かれるからだ。日常的な運用として圧縮を回す手順はClaude Code /compact|長時間開発の5手順にまとめている。
/context の側にも警告が出る。Context exceeds the 200k-token limit by 94k tokens — run /compact or /clear to continue. のように、超過分がそのまま表示される(v2.1.216より前は100%超の表示だけで、説明の行が無かった)。1Mコンテキストのモデルで圧縮の境界を超えた場合は Context is 94k tokens past the 200k-token compaction window — run /compact to reduce usage. という別の文言になる。圧縮の境界はモデルのコンテキスト窓より下にあることがあり、その場合は超えていてもリクエスト自体は通る。
圧縮そのものが失敗することもある。Error during compaction: Conversation too long. Press esc twice to go up a few messages and try again. は、要約を置く空きが残っていない状態だ。Esc を2回押してメッセージ一覧を開き、数ターン戻してから /compact をやり直す。それでも足りなければ /clear で新しいセッションにする。前の会話は残っているので /resume で開き直せる。
Request too large — ボディの32MBを超えた
こちらはトークン化の前の生のリクエストボディが32MBを超えた状態で、コンテキスト窓とは別の上限だ。大量の貼り付け、ツールの結果、添付が原因になる。
Request too large (max 32MB). Accumulated images and attachments in the conversation pushed the request over the limit. Run /compact, or double press esc to go back and remove attachments.
Claude APIに直接送ってAPI自身が拒否した場合、Claude Codeは会話を測って文言を書き分ける。Request too large (max 32MB; 20.1MB of about 33.4MB is images or documents). なら画像や文書が押し上げたケースで、Claude Codeはそれらを外して再送する。Request too large for the API's 32MB request limit でメッセージだけで超えている場合は compacting cannot make it fit と付き、再送はしない。プロキシやゲートウェイ、クラウドプロバイダ経由だと一般形のメッセージになる。
したがって対処は、compacting cannot make it fit が出ていたら Esc を2回押して大きい内容を足したターンより前に戻る(または /clear)。出ていなければ /compact を打つと、蓄積した画像と添付が落ちる。そして根本的には、大きいファイルは中身を貼らずにパスで渡し、Claudeに分割して読ませる。
手順7|無人実行では「どう失敗させたいか」を先に決める
CIや -p の非対話実行では、人が画面を見ていない。だから既定の「10回粘る」が正しいとは限らない。早く失敗させたいのか、容量が空くまで待たせたいのかを、ジョブの性格で決めて環境変数に落とす。
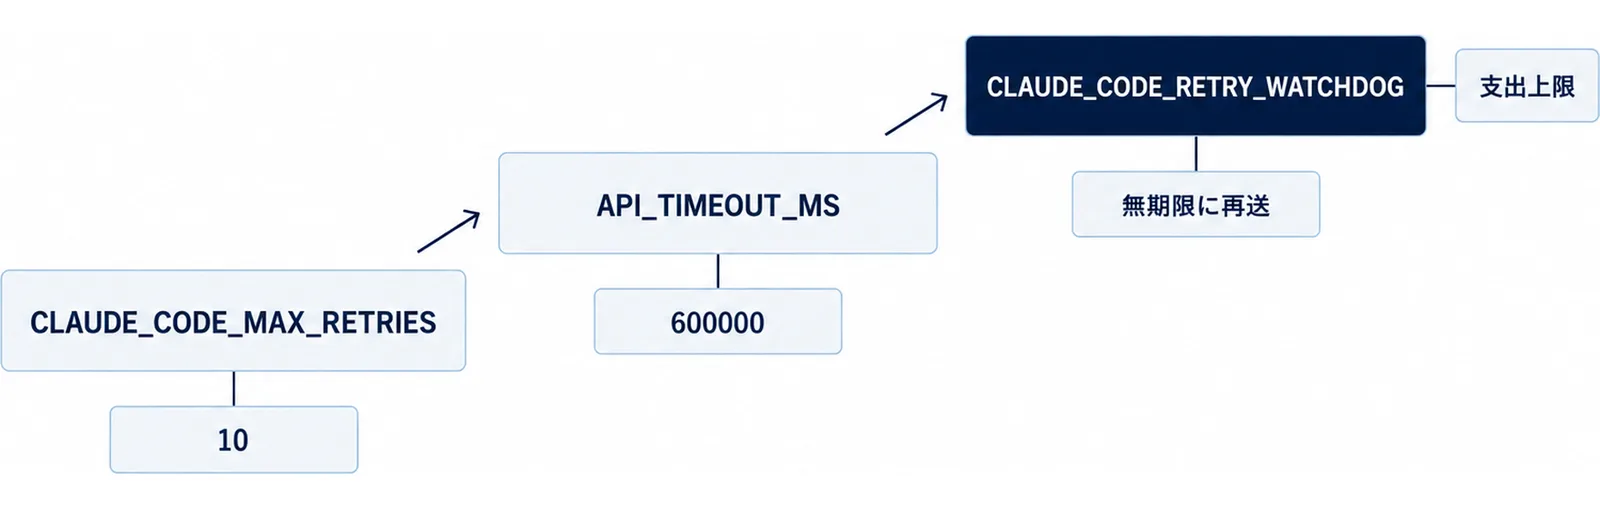
再送の回数と粘り方
| 変数 | 既定 | 何を変えるか |
|---|---|---|
CLAUDE_CODE_MAX_RETRIES |
10 | 再送の試行回数。v2.1.186以降は15が上限で、v2.1.199の CLAUDE_CODE_RETRY_WATCHDOG は既定値を引き上げて上限を外す。スクリプトでは下げて早く失敗を表に出す |
CLAUDE_CODE_RETRY_WATCHDOG |
未設定 | 1 にすると、CIのような無人セッションで 429 と 529 の容量エラーを無期限に再送する |
API_TIMEOUT_MS |
600000 | 1リクエストのタイムアウト(ミリ秒)。遅いネットワークやプロキシでは上げる |
CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS |
未設定 | ストリーミングの最初の1バイトの期限(ミリ秒)。v2.1.242以降で有効 |
CLAUDE_CODE_RETRY_WATCHDOG=1 にしても無条件に粘るわけではない。標準速度のリクエストが、支出上限や使用クレジットの枯渇を報告する 429 を受けた場合は、その場で失敗する。待っても空かない種類の429を無期限に待たないようになっている。逆に言えば、CIが「待てば通る」前提で組まれているなら、支出上限のほうは待っても解決しないので、ジョブ側で別に扱う必要がある。
ジョブの性格で分けるとこうなる。デプロイ前の短いチェックのように結果が早く欲しいものは CLAUDE_CODE_MAX_RETRIES を下げ、落ちたらそのまま失敗として扱う。夜間のバッチのように完了することが重要なものは CLAUDE_CODE_RETRY_WATCHDOG=1 を置き、容量が空くのを待たせる。
無人実行で見ることになるメッセージ
サブエージェントを使っている場合、上限や5xxの再送を使い切って止まると、親側にはこう出る。
Agent terminated early due to an API error: <error detail>
コロンの後ろが本当の原因だ。そこをこの記事の該当手順に当てて処理する。このメッセージはv2.1.199以降で、それ以前はAPIのエラー文がそのまま返っていた。前面のサブエージェントが既にテキストを出していた場合は、このエラーではなく不完全な部分出力がClaudeに渡る。
ゲートウェイ越しのCIでは、次のエラーも出やすい。
API returned an empty or malformed response (HTTP 200) — check for a proxy or gateway intercepting the request.
HTTPは成功なのに、本文がClaude APIのメッセージではない状態だ。HTMLのエラーページ、サインインページ、空のボディ、別形式のJSONが典型で、Response: の節にコンテンツタイプ・本文の種類・バイト数・Anthropicのリクエストidの有無が出る。nginx や cloudflare のようなサーバー名が出たら、APIの代わりに途中の何かが答えている。ゲートウェイの非ストリーミング経路だけが壊れているなら CLAUDE_CODE_DISABLE_NONSTREAMING_FALLBACK=1 を設定して、途中で失敗したリクエストを通常の再送経路に戻す。
どこに報告するか
対処しても直らず、ドキュメントにも載っていないエラーなら、/feedback でトランスクリプトと説明をAnthropicに送る。このコマンドはGitHubのissueを下書き済みで開く選択肢も出す。/feedback が使えない環境では、claude doctor(シェルからの読み取り専用の診断)と /doctor(セッション内の点検)を走らせ、status.claude.comで障害を確認し、GitHubの既存issueを検索する、という順になる。
想定の切り分け例(実測値ではありません)
以下は公式ドキュメントの仕様から組み立てた想定のシナリオで、実際の環境での測定結果ではない。
想定1:朝だけ API Error: Request rejected (429) が出るチーム
全員が始業直後に走らせているなら容量の話にも見えるが、文言は Server is temporarily limiting requests ではない。/status を見たら、共有のCI用キーが各自のシェルの ANTHROPIC_API_KEY に残っていて、サブスクリプションではなくそのキーのレート上限を全員で分け合っていた、というのが想定される外し方だ。この場合は変数を外すのが対処で、待っても混雑も解消しない。
想定2:長い改修だけ No response from API で落ちる
短いやり取りは通るのに、生成が長くなるものだけ落ちる。プロキシが応答を生成完了まで溜め込んでいると、最初の1バイトが来ないままこの期限に当たる。再送のほうは API_TIMEOUT_MS より1秒短い期限で待つので、「1回目は落ちて2回目は通る」という出方になりやすい。想定される対処は CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS を上げて初回の待ちを伸ばすことで、CLAUDE_CODE_MAX_RETRIES を増やしても初回の期限は変わらない。
想定3:夜間バッチが毎回どこかで落ちる
Agent terminated early due to an API error: の後ろを集計したら 529 が大半だった、という想定だ。ここは設定の問題ではないので、CLAUDE_CODE_RETRY_WATCHDOG=1 を置いて容量が空くまで待たせるのが素直な対処になる。ただし支出上限の 429 は待っても通らないため、ジョブ側でそのケースだけ別に検知する必要がある。
今日やる3つ
- いま出ているエラー文を、サーバー側・上限・リクエスト側・ネットワークのどれかに割る。割れたら、この記事の該当手順だけを読む。
/statusと/usageを開いて、アクティブな資格情報とプランの窓を確認する。上限系のエラーは、ここで原因が半分決まる。特にANTHROPIC_API_KEYの残留は見つけたその場で外す。- 無人実行しているジョブがあるなら、
CLAUDE_CODE_MAX_RETRIESとCLAUDE_CODE_RETRY_WATCHDOGの方針を明文化する。「早く落とす」か「待たせる」かを決めていないジョブは、障害のたびに挙動が変わる。
よくある質問
API Error: 500 が出ました。すぐ送り直していいですか
送り直して構いませんが、連打には意味がありません。Claude Codeはこのエラーを表示する前に、既定で最大10回の再送を終えています。status.claude.comで障害の有無を見て、1分待ってから送り直してください。長いプロンプトなら貼り直さずに try again と打てば足ります。元のメッセージは会話に残っています。
429と529は、どちらも「混んでいる」ではないのですか
違います。529 はサービス全体が一時的に容量上限にある状態で、あなたのクォータは消費されません。API Error: Request rejected (429) はあなたのAPIキー、Amazon Bedrockのプロジェクト、Google Cloudのプロジェクトに設定されたレート上限です。前者は待つかモデルを変える、後者は資格情報と並列度を見直す、と対処が分かれます。なお API Error: Server is temporarily limiting requests (not your usage limit) と表示される短命なスロットルは、文言のとおりプランの上限とは無関係です。
529 でモデルを切り替えると、会話は引き継がれますか
会話はそのまま続きます。ただしモデルごとにプロンプトキャッシュが別なので、切り替え後の最初のリクエストはキャッシュに当たらず、会話全体を読み直すことになります。短時間で何度も往復させる作業では、その分のコストと待ち時間を見込んでください。
Prompt is too long で /compact を打ったのに失敗します
2つの可能性があります。ひとつは要約を置く空きが残っていない場合で、Error during compaction: Conversation too long. が出ます。Esc を2回押して数ターン戻してからやり直してください。もうひとつは、自動圧縮が別の原因で失敗している場合です。Prompt is too long · automatic compaction failed: <the underlying error> のように原因が併記されているなら、そのエラーを先に解決しない限り /compact も同じ理由で失敗します。
CIのログに Agent terminated early due to an API error しか出ません
コロンの後ろのエラー詳細が本当の原因です。上限系なら手順3、5xxや529なら手順3の前半、タイムアウトなら手順4に当ててください。原因が解消したら、Claudeにタスクを再実行させるか、サブエージェントを再開させます。このメッセージ自体はv2.1.199以降の形式です。
API returned an empty or malformed response (HTTP 200) は何が起きていますか
HTTPは成功なのに、本文がClaude APIのメッセージではない状態です。プロキシやゲートウェイ、ゲストWi-Fiのサインインページが代わりに応答しているのが典型で、Response: の節に本文の種類とサーバー名が出ます。サインインページならブラウザで認証を済ませてから再試行し、ゲートウェイ経由なら直接リクエストで経路を切り分けてください。
401 や 403 が出ます。これもこの記事の4分類に入りますか
入りません。API Error: 401 Invalid authentication credentials や、ログイン後の 403 Forbidden は認証のレイヤーで、Claude Codeがあなたを証明できていない状態です。/status でアクティブな資格情報を確認し、環境変数の ANTHROPIC_API_KEY が意図せずサブスクリプションを上書きしていないかを見てください。ログインまわりの詰まり方はClaude Codeがインストールできない原因と対処7手順の後半にまとめています。
/doctor と claude doctor はどう違いますか
/doctor はセッション内で走る点検で、インストール・設定・拡張・コンテキスト使用量を調べ、適用できる修正を確認のうえ提案します。claude doctor はシェルから走らせる読み取り専用の診断で、claude がそもそも起動しないときに使います。
あわせて読みたい
運営元 Uravation よりこの事例を自社の業務で試す場合のテーマ選定・評価・本番移行の確認項目を、無料のチェックリストにまとめています。 Claude Code業務自動化PoCチェックリストを受け取る(無料)
参考・出典
- Anthropic「Error reference(Claude Code Docs)」(自動リトライの回数と再送する/しない失敗、
Retrying in Ns · attempt x/yと20秒・90秒の表示、500と529の文言と対処、Server is temporarily limiting requests/Request rejected (429)/spend limit reachedの3種、session・weekly・Opus・Sonnetの上限、Request timed outの10分、No response from APIの初回と再送の期限、The response above may be incompleteの4文言、Prompt is too longとContext exceeds the token limitとError during compaction、Request too largeの32MB、Agent terminated early due to an API error、API returned an empty or malformed response、報告先) - Anthropic「Environment variables(Claude Code Docs)」(
CLAUDE_CODE_MAX_RETRIESの既定10とv2.1.186の上限15、CLAUDE_CODE_RETRY_WATCHDOG、API_TIMEOUT_MSの既定600000、CLAUDE_STREAM_FIRST_BYTE_TIMEOUT_MS、CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY、CLAUDE_CODE_DISABLE_NONSTREAMING_FALLBACK、DISABLE_COMPACTとDISABLE_AUTO_COMPACT) - Anthropic「Commands(Claude Code Docs)」(
/status/usage/usage-credits/model/context/compact/clear/resume/config/feedback/doctorの役割) - Anthropic「Troubleshooting(Claude Code Docs)」(症状から参照先を振り分ける表、
/doctorとclaude doctorの使い分け) - Anthropic「Network configuration(Claude Code Docs)」(プロキシ設定とストリーミングの監視タイマー、許可が必要なホスト)
- Anthropic「Manage costs effectively(Claude Code Docs)」(ワークスペース単位の支出上限とコスト管理)
- Anthropic「Rate limits(Claude Docs)」(APIキーのティアとワークスペース単位の上限の考え方)
- Anthropic「Claude status」(障害と容量に関する告知の確認先)
- AWS「Quotas for Amazon Bedrock」(Bedrock経由で
Request rejected (429)が出た場合に確認するクォータ) - GitHub「anthropics/claude-code — Issues」(
/feedbackが使えない環境での既存issueの検索先)